一、Logstash file 输入的 offset 与重新采集#
1.1 offset 记录在 sincedb 文件中#
Logstash 会在 /usr/share/logstash/data/plugins/inputs/file/ 目录下生成 .sincedb_<文件路径哈希> 文件,记录每个被采集文件当前的读取位置(offset)。
下次启动时从这个位置继续采集,不会把整个文件重读一遍。
1.2 重新导入旧数据的完整步骤#
1 停止 logstash
2 清除 sincedb 文件
1
|
root@elk03:/etc/logstash# rm -f /usr/share/logstash/data/plugins/inputs/file/.sincedb_c3e21f60a15f19878632de9b335e4596
|
.sincedb_ 后的哈希由被采集文件的路径决定,不同文件文件名不同;删之前先 ls /usr/share/logstash/data/plugins/inputs/file/ 确认。
3 重启 logstash
要指定采集文件的起始位置。
1
|
root@elk03:/etc/logstash# vim config/03-file-filter-elasticsearch.conf
|
1
2
3
4
5
6
|
input {
  file {
    path           => ["/tmp/apps.log"]
    start_position => "beginning"
  }
}
|
本节只关注 input 的读取位置行为,filter 拆分解法与完整配置见 2.2 节。
演示用日志 /tmp/apps.log,每行以 | 分隔 5 段,首段为「程序名 + 日期 + 时间」:
1
|
apps 2026-10-19 10:00:00|1001|login|svip01|9.9
|
1
|
root@elk03:/etc/logstash# logstash -rf config/03-file-filter-elasticsearch.conf
|
二、Logstash 处理日志的访问时间(date 插件)#
2.1 date 插件#
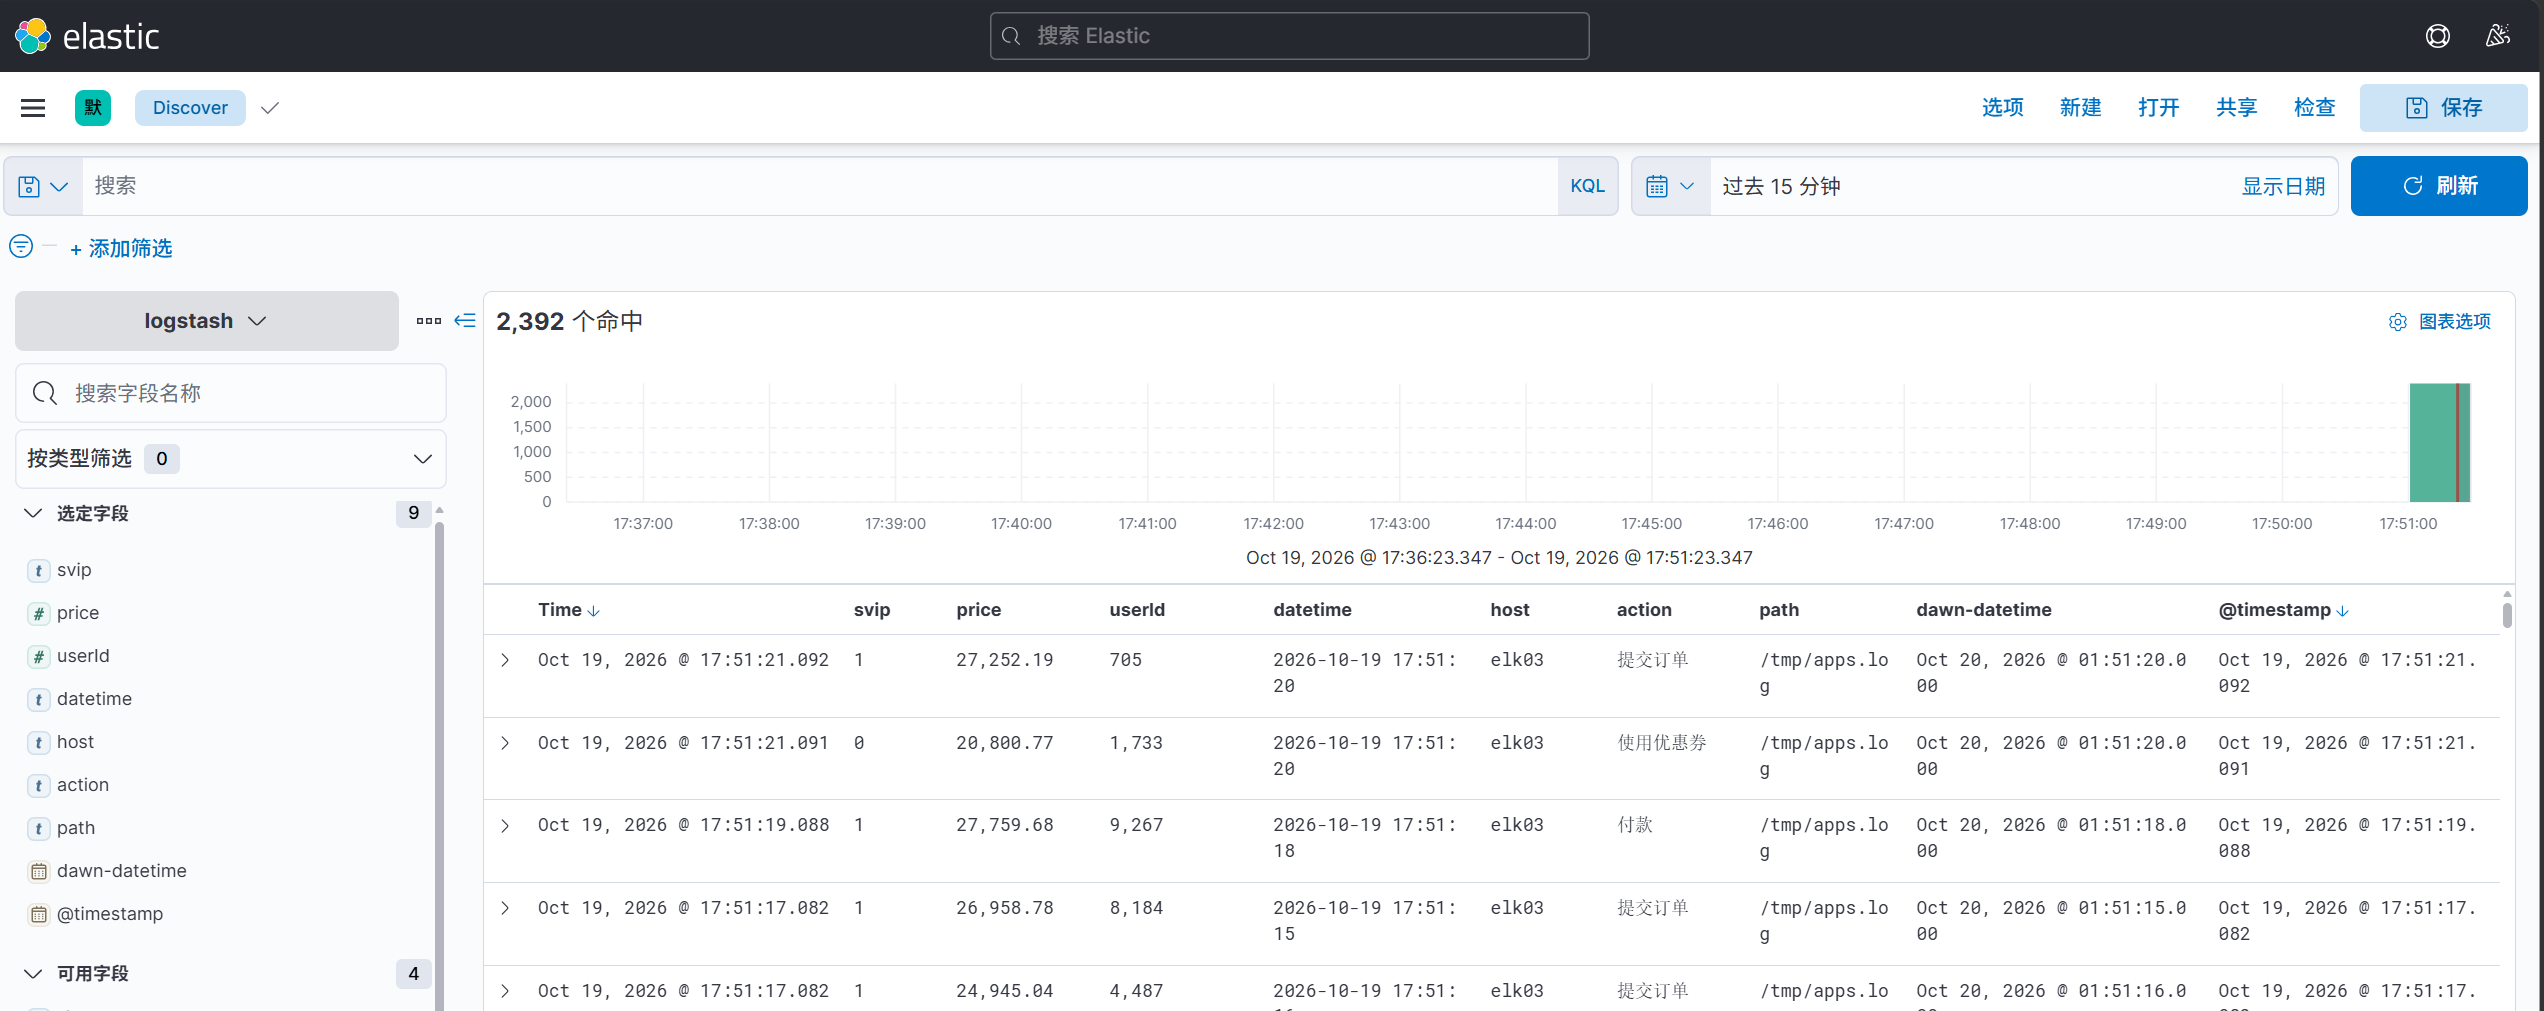
专门用于处理日志的日期模块,将其作为时间戳可以替换"@timestamp"字段。
将来kibana基于该字段进行时间查询。
2.2 编写 logstash 配置文件#
1
|
root@elk03:/etc/logstash# vim config/03-file-filter-elasticsearch.conf
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
|
input {
  # 输入类型是一个file,代表的是文本文件
  file {
    # 指定的文件的路径,可以指定多个
    path => ["/tmp/apps.log"]
    # 指定从源文件采集的位置,有效值为: beginning, end(默认值)。
    # 该参数仅在首次采集(没有在".sincedb*"文件中记录)新文件时生效,第二次采集则无视此参数。
    start_position => "beginning"
  }
}

filter {
  mutate {
      # 对指定字段进行切分,本案例是将message字段按照"|"进行切分
      split => { "message" => "|" }

      # 添加字段
      add_field => {
         "other" => "%{[message][0]}"
         "userId" => "%{[message][1]}"
         "action" => "%{[message][2]}"
         "svip" => "%{[message][3]}"
         "price" => "%{[message][4]}"

      }
  }

  mutate {
      split => { "other" => " "}
      add_field => {
         datetime => "%{[other][1]} %{[other][2]}"
      }

      # 移除字段
      remove_field => [ "message" , "other", "@version"]
  }

  mutate {
     # 对字段进行数据转换
     convert => {
       "price" => "float"
       "userId" => "integer"
     }
  }

   # 处理时间相关的模块
   date {
     # 匹配日期字段,将"datetime" 转换为日期格式
     match => [ "datetime", "yyyy-MM-dd HH:mm:ss" ]

     # 使用match匹配到的时间数据类型存储在哪个字段中,若不指定,则默认使用覆盖"@timestamp"
     target => "dawn-datetime"
   }

}

output {
  stdout {}

 elasticsearch {}
}
|
注意:date 插件不指定 timezone 时默认按 UTC 解析,本地时间(+08:00)解析后在 Kibana 里查会差 8 小时;需要与本地时间一致时加上 timezone => "Asia/Shanghai"。
2.3 启动 logstash 实例#
1
|
root@elk03:/etc/logstash# logstash -rf config/03-file-filter-elasticsearch.conf
|
2.4 Kibana 查询验证#
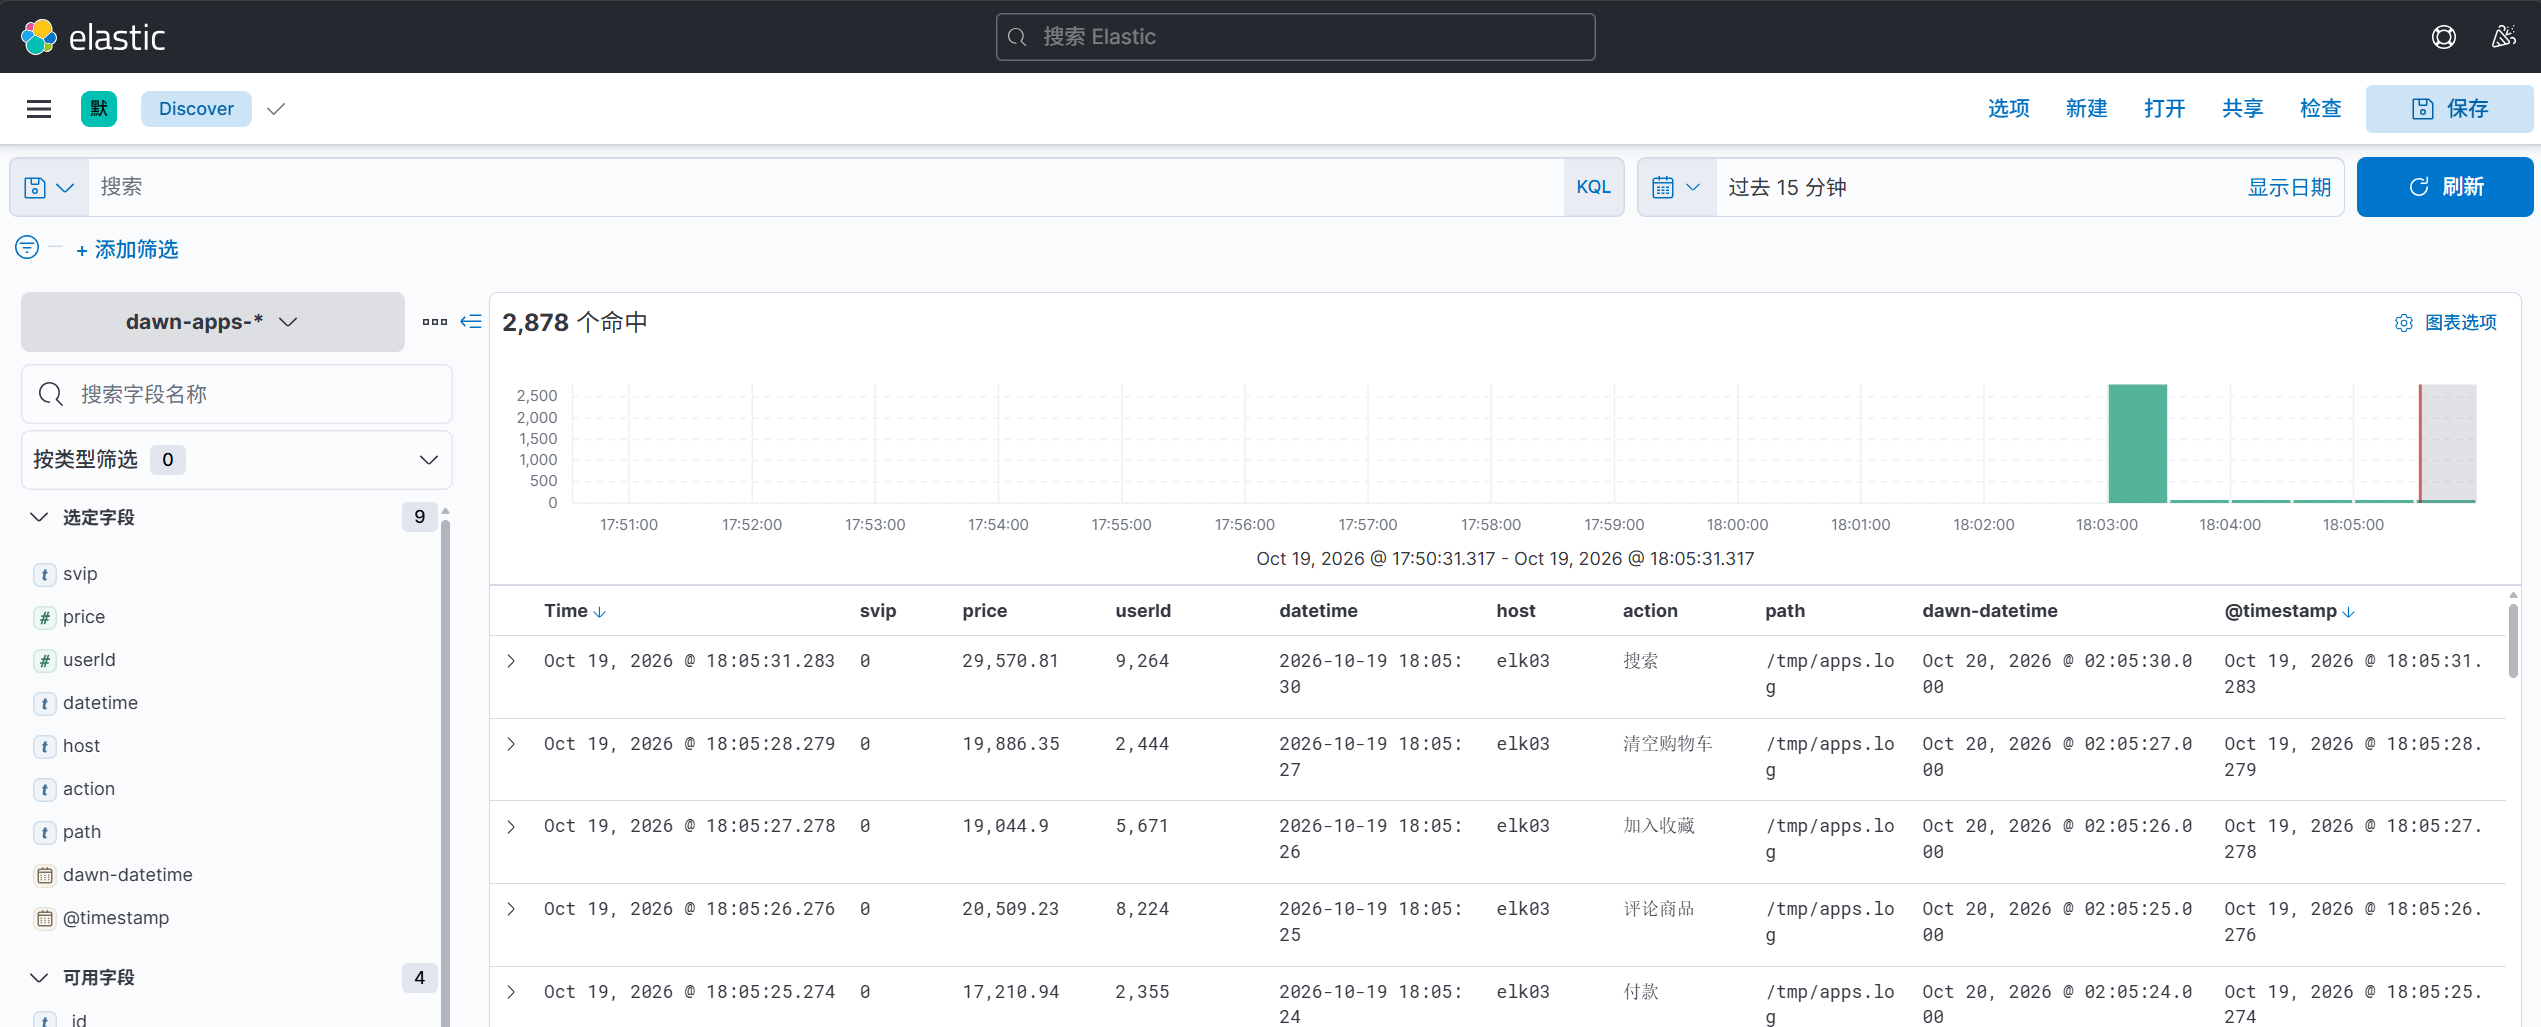
三、Logstash 写入 ES 自定义索引名称#
1
|
root@elk03:/etc/logstash# vim config/04-file-filter-elasticsearch_custom_index.conf
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
|
input {
  # 输入类型是一个file,代表的是文本文件
  file {
    # 指定的文件的路径,可以指定多个
    path => ["/tmp/apps.log"]
    # 指定从源文件采集的位置,有效值为: beginning, end(默认值)。
    # 该参数仅在首次采集(没有在".sincedb*"文件中记录)新文件时生效,第二次采集则无视此参数。
    start_position => "beginning"
  }
}

filter {
  mutate {
      # 对指定字段进行切分,本案例是将message字段按照"|"进行切分
      split => { "message" => "|" }

      # 添加字段
      add_field => {
         "other" => "%{[message][0]}"
         "userId" => "%{[message][1]}"
         "action" => "%{[message][2]}"
         "svip" => "%{[message][3]}"
         "price" => "%{[message][4]}"

      }
  }

  mutate {
      split => { "other" => " "}
      add_field => {
         datetime => "%{[other][1]} %{[other][2]}"
      }

      # 移除字段
      remove_field => [ "message" , "other", "@version"]
  }

  mutate {
     # 对字段进行数据转换
     convert => {
       "price" => "float"
       "userId" => "integer"
     }
  }

   # 处理时间相关的模块
   date {
     # 匹配日期字段,将"datetime" 转换为日期格式
     match => [ "datetime", "yyyy-MM-dd HH:mm:ss" ]

     # 使用match匹配到的时间数据类型存储在哪个字段中,若不指定,则默认使用覆盖"@timestamp"
     target => "dawn-datetime"
   }

}

output {
  stdout {}

 elasticsearch {
    # 指定ES集群地址
    hosts => ["http://11.0.1.111:9200","http://11.0.1.112:9200","http://11.0.1.113:9200"]
    # 指定ES自定义索引的名称
    index => "dawn-apps-%{+yyyy.MM.dd}"
 }

}
|
1
|
root@elk03:/etc/logstash# logstash -rf config/04-file-filter-elasticsearch_custom_index.conf
|
四、Logstash 的 grok 自定义正则与常用 filter 插件#
4.1 grok 的语法#
把正则封装成可复用的模式,再给捕获组起字段名。
1
2
|
%{SYNTAX:SEMANTIC}          # 模式名:字段名
%{SYNTAX:SEMANTIC:TYPE}     # 可加类型转换 int/float,如 %{NUMBER:bytes:int}
|
字段名不要带.,会被当成嵌套层级。
4.2 自定义模式文件#
1
2
|
root@elk03:/etc/logstash# mkdir -pv /etc/logstash/dawn-patterns/
root@elk03:/etc/logstash# vim /etc/logstash/dawn-patterns/dawn
|
1
2
3
|
SCHOOL (dawn|devops|k8s)
CLASS [a-z0-9]+[0-9]{2}
YEAR4 (19|20)[0-9]{2}
|
1
|
root@elk03:/etc/logstash# vim /etc/logstash/dawn-patterns/school.yml
|
1
2
3
|
"dawn": "黎明实验室"
"devops": "DevOps 学院"
"k8s": "云原生学院"
|
yml 字典的 key 要加引号,否则数字 key 会和字段里的字符串对不上。
4.3 编写 07 完整配置#
1
|
root@elk03:/etc/logstash# vim config/07-grok-custom-filters-es.conf
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
|
input {
  # filebeat 走 beats 协议
  beats { port => 9999 }

  # 调试链路,nc/bash 直接送纯文本,省掉 filebeat
  tcp   { port => 9998 }
}

filter {

  # 自定义 grok,时间用模式抽
  grok {
    patterns_dir   => ["/etc/logstash/dawn-patterns/"]

    match => {
      "message" => "%{TIMESTAMP_ISO8601:dawn_datetime} %{SCHOOL:dawn_school} haha %{CLASS:dawn_class} xixi %{YEAR4:dawn_year} %{IP:dawn_ip} %{GREEDYDATA:dawn_ua}"
    }

    tag_on_failure => ["_grokparsefailure", "dawn_grok_fail"]
  }

  # date,把日志真实时间写进 @timestamp
  date {
    match  => ["dawn_datetime", "yyyy-MM-dd HH:mm:ss", "ISO8601"]
    target => "@timestamp"
  }

  # geoip,指定本地库
  geoip {
    source   => "dawn_ip"
    database => "/etc/logstash/GeoLite2-City.mmdb"
  }

  useragent {
    source => "dawn_ua"
    target => "dawn_device"
  }

  # translate,字典富化
  translate {
    source          => "dawn_school"
    target          => "dawn_school_cn"
    dictionary_path => "/etc/logstash/dawn-patterns/school.yml"
    fallback        => "未知"
  }

  mutate {
    rename    => { "host" => "dawn-host" }
    convert   => { "dawn_year" => "integer" }
    add_field => { "dawn_label" => "%{dawn_school}-%{dawn_class}" }
  }

  # ruby,把 geoip 的 {lat,lon} 对象转成 [经度,纬度] 数组
  ruby {
    code => '
      loc = event.get("[geoip][location]")
      if loc
        event.set("dawn_geo", [loc["lon"], loc["lat"]])
      end
    '
  }

  # 收尾清理
  mutate {
    remove_field => ["ecs", "input", "@version", "log", "message"]
  }
}

output {
  stdout { codec => rubydebug }

  elasticsearch {
    hosts => ["http://11.0.1.111:9200","http://11.0.1.112:9200","http://11.0.1.113:9200"]
    index => "dawn-logstash-grok-%{+yyyy.MM.dd}"
  }
}
|
4.4 启动 logstash#
1
|
root@elk03:/etc/logstash# logstash -rf config/07-grok-custom-filters-es.conf
|
日志出现 Pipelines running 才算就绪
4.5 发送测试数据#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
|
root@elk03:/tmp# cat > send_testdata.sh <<'EOF'
#!/bin/bash
exec 3<>/dev/tcp/127.0.0.1/9998 || { echo "CONNECT_FAIL"; exit 1; }
sent=0
while IFS= read -r line; do
  [ -z "$line" ] && continue
  printf '%s\n' "$line" >&3
  sent=$((sent+1))
done < /tmp/grok-exp-testdata.txt
exec 3>&-
echo "SENT_TOTAL=$sent"
EOF
root@elk03:/tmp# bash send_testdata.sh
|
测试数据,5 行覆盖 3 个学校、4 种 UA,境内外 IP,最后一行故意写坏用来验证失败标签。
1
2
3
4
5
|
2026-10-20 17:20:00 dawn haha linux92 xixi 2024 123.112.21.112 Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/120.0.0.0 Safari/537.36
2026-10-20 17:20:05 devops haha k8s07 xixi 2025 8.8.8.8 Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 Version/17.0 Safari/605.1.15
2026-10-20 17:20:10 dawn haha python88 xixi 2023 202.96.134.133 Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 Chrome/119.0.0.0 Safari/537.36
2026-10-20 17:20:15 k8s haha docker33 xixi 2026 1.1.1.1 Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X) AppleWebKit/605.1.15 Mobile/15E148
2026-10-20 17:20:20 dawn haha java55 xixi # 这一行故意写坏 用来触发_grokparsefailure
|
4.6 Kibana 查询验证#
Stack Management → Index Patterns → Create index pattern,索引 dawn-logstash-grok-*,时间字段 @timestampDiscover 里确认字段:dawn_school、dawn_school_cn、dawn_class、dawn_year、dawn_label、dawn_ip、dawn_device.*、geoip.*、dawn_geo- 地图用
Maps → Add layer → Documents,地理字段选 dawn_geo
- 时间过滤器默认过去 15 分钟,历史数据要把右上角时间范围改到覆盖数据的时间段
控制台每条事件的输出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
|
{
      "@timestamp" => 2026-10-20T17:20:00.000Z,
       "dawn_school" => "dawn",
    "dawn_school_cn" => "黎明实验室",
        "dawn_class" => "linux92",
         "dawn_year" => 2024,
        "dawn_label" => "dawn-linux92",
           "dawn_ip" => "123.112.21.112",
       "dawn_device" => { "name" => "Chrome", "os_name" => "Windows", "device" => "Other" },
             "geoip" => { "country_name" => "China", "city_name" => "Beijing" },
          "dawn_geo" => [116.3889, 39.9288]
}
|
故意写坏那条的 tags 是 _grokparsefailure + dawn_grok_fail + _geoip_lookup_failure,后一个是连带的(没抽出 IP,geoip 自然失败),看到两个一起出现先查 grok。
1
2
|
root@elk03:/etc/logstash# curl -s 'http://11.0.1.111:9200/dawn-logstash-grok-2026.10.20/_count'
{"count":5,"_shards":{"total":1,"successful":1,"skipped":0,"failed":0}}
|
4.7 常用 filter 插件速查#
1. mutate#
字段增删改、类型转换,出场率最高。注意 mutate 内部各操作是固定顺序(coerce→rename→update→replace→convert→gsub→uppercase→capitalize→lowercase→strip→remove→split→join→merge→copy),跟书写顺序无关,有先后依赖要拆成多个 mutate 块。
1
2
3
4
5
6
7
8
|
mutate {
  split        => { "message" => "|" }
  add_field    => { "userId" => "%{[message][1]}" }
  convert      => { "price" => "float", "userId" => "integer" }
  rename       => { "host" => "dawn-host" }
  gsub         => [ "request", "\?.*$", "" ]
  remove_field => [ "message", "@version" ]
}
|
2. date#
1
2
3
4
|
date {
  match  => ["timestamp", "dd/MMM/yyyy:HH:mm:ss Z", "ISO8601"]
  target => "@timestamp"
}
|
不写 target 就覆盖 @timestamp。MMM 匹配英文月份缩写,依赖 JVM locale,中文 locale 下要加 -Duser.language=en -Duser.country=US 或改用数字月份。
3. geoip#
1
2
3
4
5
|
geoip {
  source   => "clientip"
  database => "/etc/logstash/GeoLite2-City.mmdb"
  target   => "geoip"
}
|
不写 database 会联网下库,内网首次卡 90s+ 再失败。内网 IP 查不到地理信息,字段为空是正常的。
4. useragent#
1
2
3
4
|
useragent {
  source => "agent"
  target => "dawn_device"
}
|
产出 dawn_device.name(浏览器)、os_name(系统)、device(设备类型)。
5. translate#
1
2
3
4
5
6
7
|
translate {
  source          => "dawn_school"
  target          => "dawn_school_cn"
  dictionary_path => "/etc/logstash/dawn-patterns/school.yml"
  fallback        => "未知"
  refresh_interval => 300
}
|
6. kv#
1
2
3
4
5
6
7
|
kv {
  source      => "request"
  field_split => "&"
  value_split => "="
  trim_key    => "?"
  target      => "dawn_params"
}
|
不写 target 会平铺到事件顶层,容易和别的字段打架。
7. json#
1
2
3
4
|
json {
  source         => "message"
  tag_on_failure => ["_jsonparsefailure"]
}
|
日志本身就是 JSON 的话,优先在 filebeat 端用 json.keys_under_root: true 解析,省掉 Logstash 这一步。
8. csv#
1
2
3
4
5
|
csv {
  source  => "message"
  columns => ["time", "level", "msg", "cost"]
  convert => { "cost" => "float" }
}
|
9. dissect#
固定分隔符的日志优先用它,比 grok 快数倍,不做正则回溯。
1
2
3
4
5
6
|
dissect {
  mapping => {
    "message" => "%{clientip} - %{ident} [%{timestamp}] \"%{verb} %{request}\" %{response} %{bytes}"
  }
  remove_field => ["message"]
}
|
10. ruby#
1
2
|
# 代码同 4.3 节 07 配置中的 ruby 块:把 geoip.location 的 {lat,lon} 对象拼成 [经度,纬度] 数组。
# dawn-geo 在 ES 侧映射为 geo_point 后,Kibana Maps 才能直接选它做地理图层。
|
同步阻塞,高吞吐场景能不用就不用。